話しながら業務をやり、カメラを回し続ける。そうやって撮った長回しの動画を渡すと、9月3日に公開されたGPT-6 Astraが、使うカットを選び、手順の見出しと字幕を付けた解説動画に組み直します。今回は介護技術の実演動画を題材に、Codex上のGPT-6 Astraでどこまで形になるかを実験しました。
これまで、研修動画づくりでは、工程を分解し、撮る場面を決め、寄りやリテイクを段取りしてから撮るのが普通でした。今回はその準備がなく、構成は撮ったあとにAIが声から起こしています。使うカットを選んで並べ、文字を載せるところまで、編集ソフトを開かずに済んだ。これが今回いちばん伝えたい事実です。AIが動画をどう読んでいるのか、長回しの素材に何があれば足りるのか、人がどこを確認すべきかを、できあがった画面とあわせて解説します。
4分と8分の長回しが、2分と5分22秒の解説動画になった
素材は2本です。ベッドから車いすへの移乗が4分08秒、仰向けから横向きへの体位交換とポジショニングが7分55秒。どちらもスマートフォン1台の長回しで、実演する人が声で説明し、患者役の同僚に声を掛けながら進めています。台本も工程表もありません。
GPT-6 Astraが組み直した結果、移乗は2分00秒、体位交換は5分22秒になりました。動画の分析から章と手順の区切りが自動で起こされ、手順の名前も撮影時の発話から付いています。体位交換の方は、AIに自分の出力を採点させる追加の検証を通して、必要な説明を戻す構成の手直しが1、2回入っています。
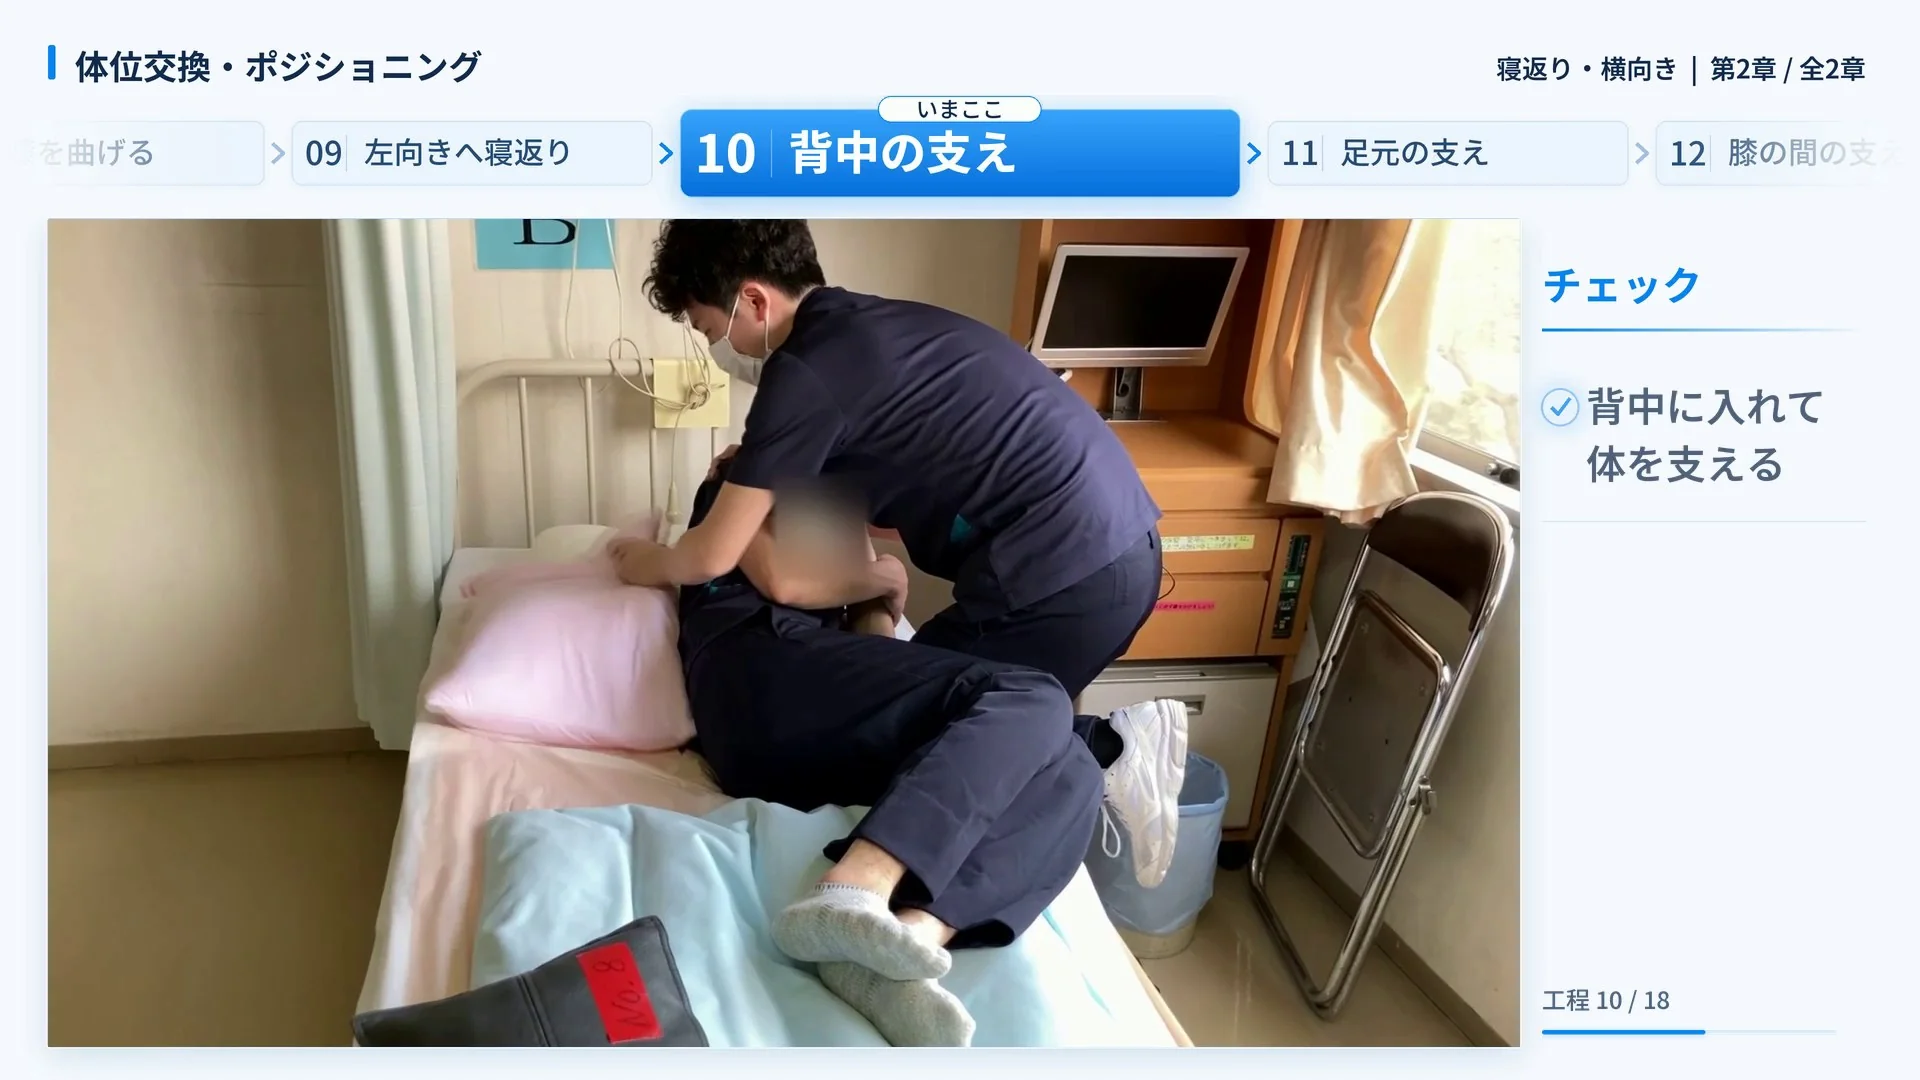
体位交換の完成画面の抜粋。上に手順の見出し、左に実演、右にチェック欄
画面の作りは共通です。上には、いまどの手順かを示す見出しが並び、現在の手順が中央に大きく、前後の手順が小さく表示されます。手順が進むと見出しの列が横に流れ、次の手順が中央に入ります。左には実演の映像が16:9のまま大きく置かれ、映像の中に実際の声掛けを引用した字幕が出ます。右には「チェック」の欄があり、その手順で確認することが短い一文で示されます。チェックが切り替わるときに短い効果音が鳴り、BGMは小さな音量で一定です。
音声は撮影時の原音のままです。ナレーションの追加、音声や映像の生成、元の実演にない注意事項の追加はしていません。切ったのは待ち時間、重複した説明、言い直しやフィラーで、動作の途中は等速で残っています。冒頭には短い導入、章の切り替わりにはつなぎの画面、最後には元の挨拶を使った振り返りが付きました。
完成した2本からの抜粋(24秒、音声あり)。声掛けの字幕、手順の見出しの動き、チェックの切り替わり
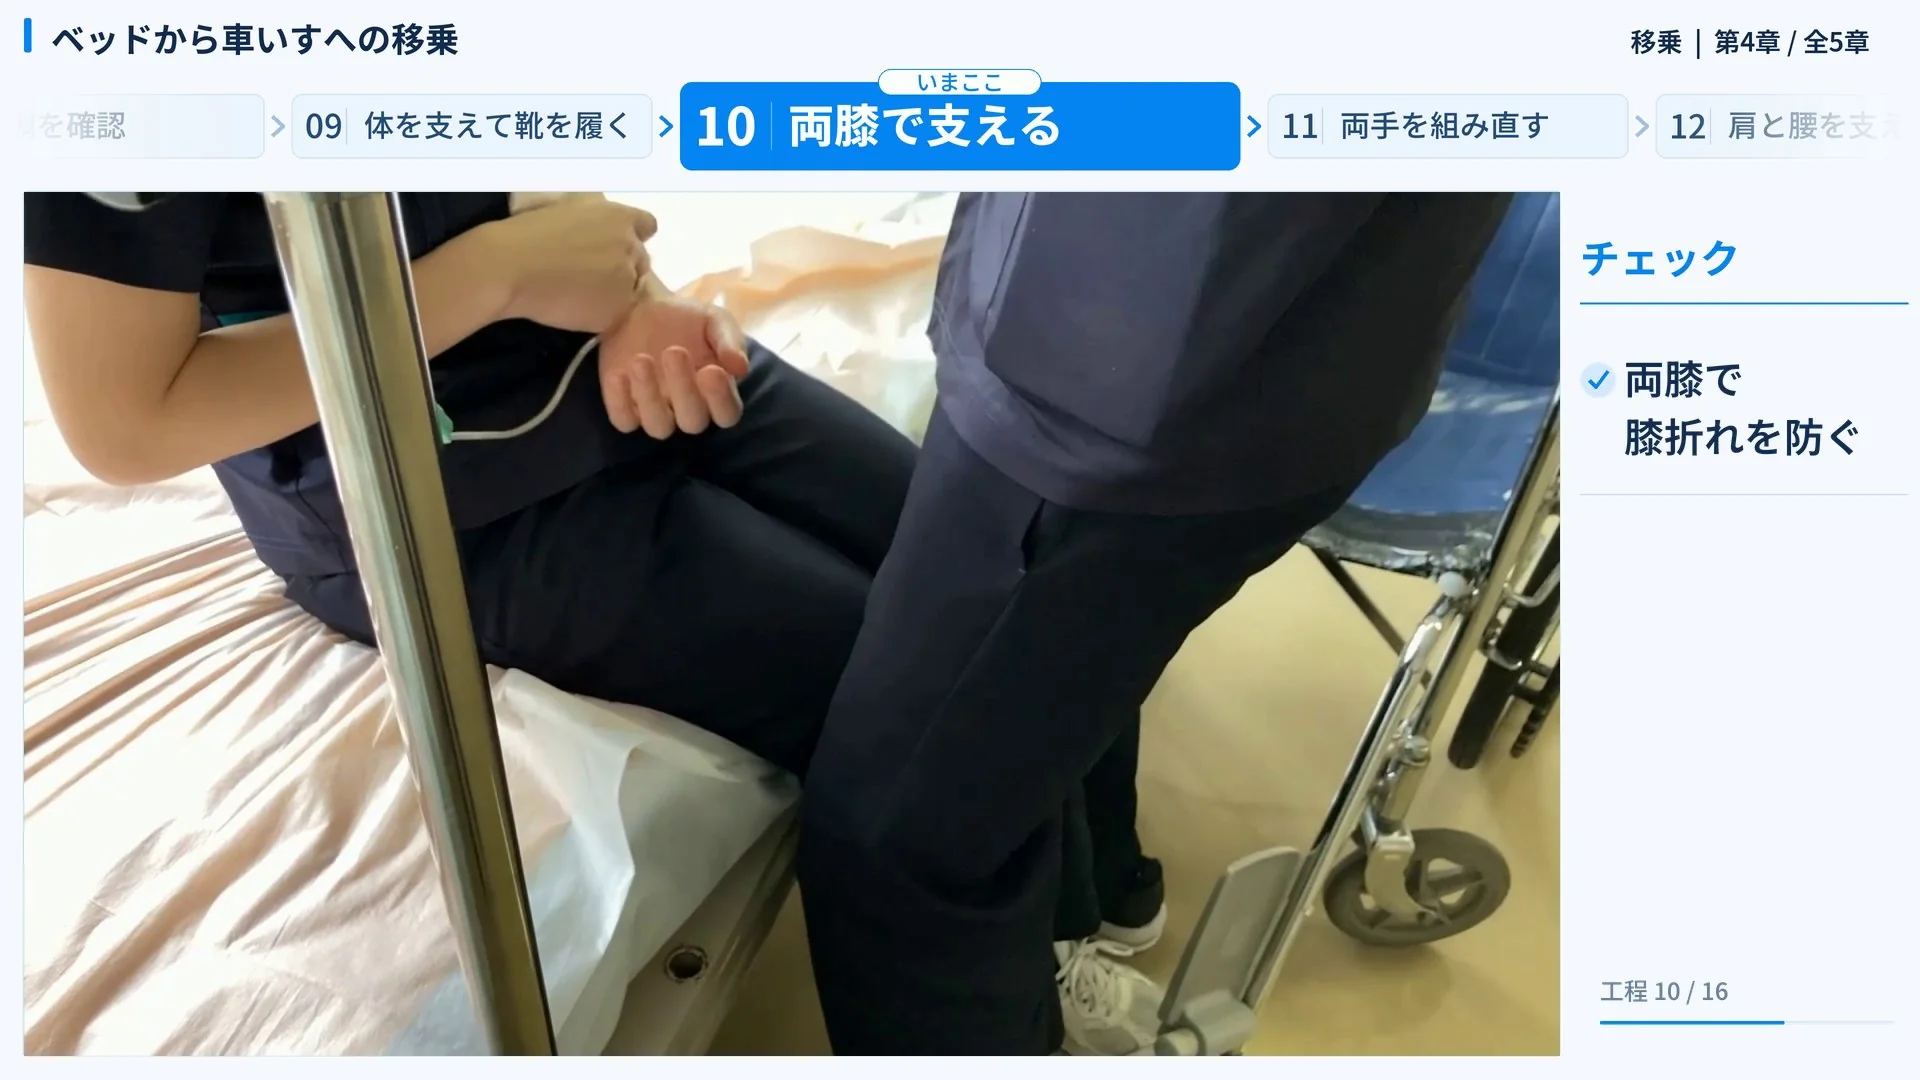
移乗の完成画面の抜粋。手順「両膝で支える」
GPT-6 Astraは動画をどう読んでいるか
今回Astraに渡したのは、動画ファイルと最初のゴールだけです。そこから先の手順は、Astraが自分で決めました。というのも、GPT-6 Astraは動画ファイルを直接は受け取れず、音声も聞けません。読めるのは文字と画像です。そこでAstraは、まず動画の音声を時刻付きの文字起こしにし、その文字から場面を推論して、章と手順の区切り、残す区間、字幕とチェックの文言を先に組み立てました。そのうえで、動画から切り出した静止画と照らし合わせ、手の位置や動作の始まりと終わりを確かめて確定しています。組み立てと書き出しも、Astraが自分で書いたプログラムで行いました。
AIが動画を読む流れ。動画も音も直接は読まず、文字起こしと静止画から組み立てる
つまり、動画の骨格は音声です。話しながら撮った長回しなら、区切りも要点も声の中にあります。黙って作業している映像は、静止画で拾えなければ存在しないのと同じになります。
Astraでなければできなかったのか、という点は正直に書いておきます。同じ元動画で、ひとつ前のモデルであるGPT-5.6 Solにも試しました。こちらにはフォーマットの仕様と文字起こしまで渡し、指示書は1本、途中の確認なしという、Astraより有利な条件です。結果は、7分55秒の元動画が7分49秒になっただけでした。切れたのは前後と章の間の余白だけで、待ち時間や言い直しは残ったままです。導入の見出しの文字が重なって表示されているのに、確認記録には「崩れなし」と書いていました。Astraは、同じ8分の動画を5分22秒まで組み直しています。静止画や短い試作を数十回くり返して、自分の出力を確かめながらです。条件が同じではないので、Solでは無理だとまでは言いません。ただ、今回の条件で見えた差は、素材を読む深さと、自分の出力を疑う回数でした。
要る素材は、流れどおりに撮った、声の入った動画だけ
今回の2本に、撮影の準備はありません。台本も工程表もなく、寄りの画も別撮りしていません。AIに渡したのは、話しながら撮った動画だけでした。仕組みから言えば、条件は3つです。
1つめは、動作と同時に声で説明することです。AIは音声から構成を組むので、黙って進めた作業は区切りも要点も拾えません。移乗の動画では、靴を履かせる場面が声のない映像として残りましたが、そこだけは説明のない映像になっています。話していれば、その動作はチェックの文言まで含めて残ります。話すのは実演する本人でなくても構いません。横で解説する人がいてもよく、今回はたまたま実演者が自分で話していただけです。上手に話す必要もありません。稚拙でも、動作と同時に解説が入っていることが大事です。
2つめは、言い直しや雑談を気にしないことです。移乗の元動画には「介助する人の手は、あ、ごめんなさい」という言い直しがありましたが、AIはその部分を切り、言い直した説明から再開しています。フィラーや待ち時間も同じように消えました。寄りで見せたい場面があれば、撮影者がその場で近づけば足ります。実際、今回の元動画もカメラは動いています。撮り直したいときは、そのまま言い直して続ければよく、どのテイクを使うかはAIが選びます。
3つめは、声が聞き取れて、説明している動作が画面に映っていることです。AIは聞き取れない言葉を推測で字幕にしません。聞き取れなかった説明は、字幕にならず、音も差し替えられます。今回はスマートフォンで撮影し、音声は実演者に付けたピンマイクで拾っています。マイクは1本で構いませんが、話している声が拾えている必要があります。動作の方は、AIが静止画で「本当にそう動いているか」を確かめるので、説明と対応する動きが画面に入っていれば十分です。手元の作業でも、体操のような全身の動きでも同じです。
今回は1本の長回しでしたが、長回しであること自体は条件ではないと考えています。途中でカメラを止めてクリップが分かれていても、撮影時刻と話の流れから順番はたどれるはずで、必要なのは業務の流れどおりに撮ってあることです。ここは未検証なので見込みにとどめます。
この3つがそろえば、撮影スタッフが入れない現場でも素材が作れます。病棟、工場のライン、厨房、クリーンルーム。クルーが立ち入れない場所で、現場の人が話しながら業務を撮る。今回の素材はスマートフォンとピンマイク1本で撮ったものですが、撮影したのは自社のスタッフなので、現場の方の撮影でどこまで成り立つかは未検証です。仕組みの上で足りない条件はありません。
どこまで任せられるか
AIが決めているのは「話の中で、どこが繰り返しで、どこが待ち時間か」です。受講者にとってその説明が必須かどうかまでは、判断していません。ここが、任せきりにできない線です。
体位交換の動画で、それがはっきり出ました。最初にAIが組んだ版は、8分の元動画を4分半ほどまで削っていました。切られた中には、待ち時間や重複だけでなく、仰向けで圧のかかる場所(仙骨とかかと)の説明、横向きで支える位置(肩、脚の付け根、外くるぶし、膝)の説明、背中を支える角度の目安(約30度)といった、初めて見る人には要る説明が含まれていました。AIから見れば、実演の前に置かれた「動きのない説明」で、切ってよい候補に見えたわけです。
面白いのは、これを見つけたのもAIだったことです。元動画から「残すべき内容の一覧」を先に作らせ、それと完成動画を時刻で突き合わせて採点させると、欠けている説明が3か所、時刻付きで挙がりました。その指摘をもとに約1分を戻し、5分22秒に落ち着いています。作る側と採点する側を分ければ、AIは自分の切りすぎを見つけられます。ただし、戻すかどうかを決めたのは人です。
切る、並べる、見出しと字幕を付けるまではAI。要るかどうかの判断は人
人が見るべき箇所は、今回の記録から4つに絞れます。
- 必須の説明が残っているか。現場の人が一度通して見れば分かります。AIに「残すべき内容の一覧」を作らせておくと、突き合わせが早くなります。
- 音。AIは音を直接聞いていません。継ぎ目の不自然さ、BGMと声のバランス、聞き取りやすさは、AI自身が「未確認」と申告している項目です。
- 用語と表記。文字起こしは専門用語を誤認識することがあり、AIは推測で直しません。字幕の用語は現場の言葉に合わせて見直します。
- 誰にどこまで見せるか。映っている人や場所、社外に出せる内容かどうかは、AIの判断の外にあります。
逆に言えば、この4つを人が見る前提なら、切る、並べる、見出しと字幕を付けるところまでは任せられます。確認する側に回れるのは、AIが自分の未確認項目を正直に書き出すからでもあります。
同じ流れで、インタビューの荒編まで届く見込み
今回の仕組みを分解すると、文字起こしを読む、残す発言と区間を選ぶ、言い直しやフィラーを切る、見出しと字幕を付ける、の4つです。これは映像制作でいう荒編、つまり本編集の前に使う素材を選んで並べる作業とほぼ同じです。実演の解説動画に限らず、声が主役の素材なら同じ流れが使えるはずです。
いちばん近いのはインタビューです。話している人をカメラで押さえた素材は、今回の実演動画よりも音声の比重が高く、AIが「文字から場面を想像する」うえで迷う要素が少ない。文字起こしには話者の区別も付くので、聞き手の質問と答えを分けて扱えます。30分の素材から、使う発言だけを抜いて3分に並べる、という荒編の初稿は、今回と同じ指示の出し方で出てくる見込みです。
違いが出るのは並べ替えです。今回は元の順序を変えない条件で作らせましたが、インタビューの荒編では、発言をテーマごとに組み替えることが多い。組み替えは意味を変えることがあるので、AIには「テーマで束ねてよいが、前後の発言の意味を変えない」という条件を渡し、できあがった並びを人が読む必要があります。もうひとつは画の飛びです。同じ画角の発言を切ってつなぐと、実演動画より継ぎ目が目立ちます。寄りと引きの2台で撮っておくか、あとから画角を切り替える処理を入れるかは、人が決める部分です。
ここまでは今回の記録からの見込みで、インタビューでの検証はまだしていません。ただ、声の入った素材を「撮ってから構成する」という順番自体は、実演でもインタビューでも変わりません。
映像制作会社としての使いどころと、時間の目安
私たちにとって、この検証は自分たちの仕事の一部を置き換える話でもあります。それでも書いておく理由は、撮ってあるのに使われていない動画が、多くの会社にあるからです。研修で一度だけ流した実演の録画、引き継ぎのために撮った作業の動画、社内向けに撮ったまま眠っているインタビュー。そうした素材を、撮り直さずに解説動画へ組み直す。よつば制作所では、AIを使った解説動画サービスのヒナビの枠組みで、こうした撮影済み動画の要約や解説動画化にも対応しています。まだ定型のメニューにはしていないので、素材を見せていただいてからのご相談になります。
時間の面では、素材を渡してから初稿が出るまでが1本あたり1〜2時間でした。対話しながら作った1本目でも、半日で見られる形になっています。人の確認と手直しを含めても1〜2日です。従来は、工程を分解して撮影計画を立て、撮影日を押さえ、撮影のあとに編集で数日、確認の往復を含めて数週間という流れでした。今回はその前半がまるごと消え、撮った当日に初稿を見て、翌日には直しが終わります。研修動画を「作る」というより、撮った録画がその日のうちに研修動画になる、に近い速さです。
人が担う判断は、必須の説明が残っているかを見ること、音を聞くこと、用語を現場の言葉に合わせること、誰にどこまで見せるかを決めることです。逆に、話しながら撮った動画があれば、AIが構成を組むところまでは今日できます。手元に、撮ったまま使っていない実演や研修の録画があれば、その動画をそのまま起点に相談していただくのがいちばん早い方法です。
撮影済みの動画から解説動画をつくるご相談
研修や作業の録画、インタビューの素材から。
お手元の動画に合わせた進め方をご提案します。